Qué es RAG en inteligencia artificial y cómo integrarlo en una aplicación web
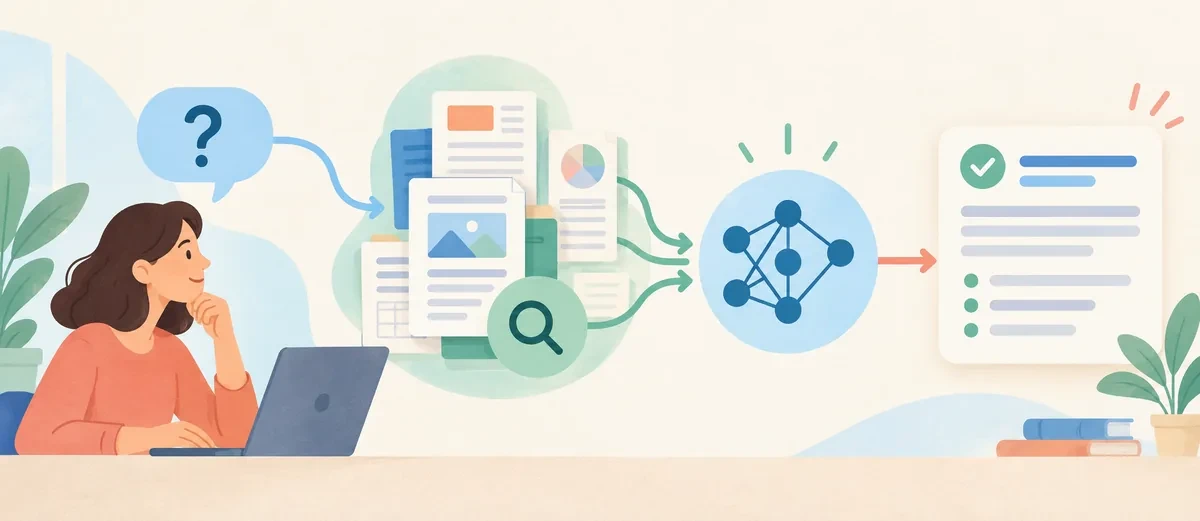
Imaginemos que estamos desarrollando una aplicación de gestión empresarial y queremos incorporar un asistente de inteligencia artificial.
El usuario podría preguntarle:
¿Cuál es el procedimiento para solicitar una modificación de un registro?
O quizá algo más específico:
Según la documentación interna de mi empresa, ¿quién puede aprobar una solicitud de modificación?
Un modelo de lenguaje como GPT, Claude o Gemini puede responder preguntas generales, generar código o explicar conceptos técnicos. Sin embargo, no conoce necesariamente la documentación privada de nuestra aplicación.
Tampoco tiene por qué conocer los procedimientos internos de una empresa, las últimas modificaciones de un manual o el contenido de una base de datos que nunca ha visto.
Podríamos intentar resolverlo enviando toda esa información junto con cada pregunta.
Pero ¿qué ocurre cuando tenemos cientos de documentos, miles de páginas o millones de registros?
Aquí entra en juego RAG, una de las arquitecturas más utilizadas para construir aplicaciones de inteligencia artificial que necesitan trabajar con información propia.
En este artículo veremos qué es, cómo funciona internamente y cómo podemos integrarlo en una aplicación web utilizando tecnologías habituales como Node.js, NestJS y PostgreSQL.
¿Qué es RAG?
RAG son las siglas de Retrieval-Augmented Generation, que podemos traducir como generación aumentada mediante recuperación de información.
La idea es relativamente sencilla.
En lugar de pedirle a un modelo de inteligencia artificial que responda únicamente utilizando el conocimiento adquirido durante su entrenamiento, primero buscamos información relevante en una fuente externa.
Después proporcionamos esa información al modelo para que construya su respuesta.
El proceso se divide en tres operaciones:
- Retrieval: recuperar información relevante.
- Augmentation: incorporar esa información al contexto del modelo.
- Generation: generar una respuesta utilizando ese contexto.
Por ejemplo, si un usuario pregunta:
¿Cuánto tiempo se conservan los registros de actividad en nuestra aplicación?
El sistema puede buscar esa información en la documentación interna y recuperar un fragmento como este:
Los registros de actividad se conservan durante
cuatro años desde la fecha de su creación.
A continuación enviamos al modelo tanto la pregunta como el fragmento recuperado.
El modelo ya no necesita inventar la respuesta ni depender exclusivamente de su entrenamiento.
Dispone de información específica sobre nuestra aplicación.
Esta es la idea fundamental de RAG.
¿Por qué no basta con utilizar directamente un LLM?
Para comprender la utilidad de RAG debemos distinguir entre el conocimiento del modelo y los datos de nuestra aplicación.
Un LLM ha aprendido patrones y relaciones durante su entrenamiento.
Ese conocimiento está representado en sus parámetros.
Pero los parámetros del modelo no funcionan como una base de datos convencional a la que podamos añadir registros individualmente.
Si mañana modificamos una política interna de nuestra empresa, el modelo no conoce automáticamente ese cambio.
Y aunque pudiera responder utilizando información general, eso no garantiza que su respuesta coincida con nuestras reglas particulares.
Supongamos que desarrollamos una plataforma SaaS.
Nuestra aplicación contiene:
- documentación funcional;
- manuales de usuario;
- procedimientos internos;
- condiciones de contratación;
- preguntas frecuentes;
- documentación técnica.
Queremos que un asistente responda preguntas utilizando esos documentos.
Sin RAG, tendríamos principalmente dos alternativas.
La primera sería incluir toda la documentación en el prompt.
La segunda, entrenar o adaptar un modelo con información específica.
Ambas presentan limitaciones.
Enviar toda la documentación puede consumir demasiados tokens y aumentar el coste y la latencia. Además, disponer de una ventana de contexto grande no garantiza que el modelo utilice correctamente toda la información.
Por otro lado, ajustar un modelo mediante fine-tuning no suele ser la solución apropiada cuando simplemente necesitamos consultar documentos actualizados.
RAG proporciona una alternativa: mantener la información fuera del modelo y recuperarla cuando sea necesaria.
Cómo funciona la arquitectura de un RAG
Un sistema RAG suele dividirse en dos procesos diferentes.
El primero prepara e indexa la información.
El segundo recupera información y genera respuestas cuando el usuario realiza una consulta.
Primera fase: preparar los documentos
Imaginemos que disponemos de una colección de archivos:
documentos/
  manual-usuario.pdf
  preguntas-frecuentes.md
  politica-seguridad.pdf
  procedimientos.docx
No resulta eficiente enviar todos esos documentos al modelo cada vez que alguien hace una pregunta.
Necesitamos preparar un índice que nos permita localizar rápidamente los fragmentos relacionados con cada consulta.
El proceso habitual es:
Documentos
     |
     v
Extracción de texto
     |
     v
División en fragmentos
     |
     v
Generación de embeddings
     |
     v
Base de datos vectorial
Veamos qué significa cada etapa.
Chunking: dividir la información en fragmentos
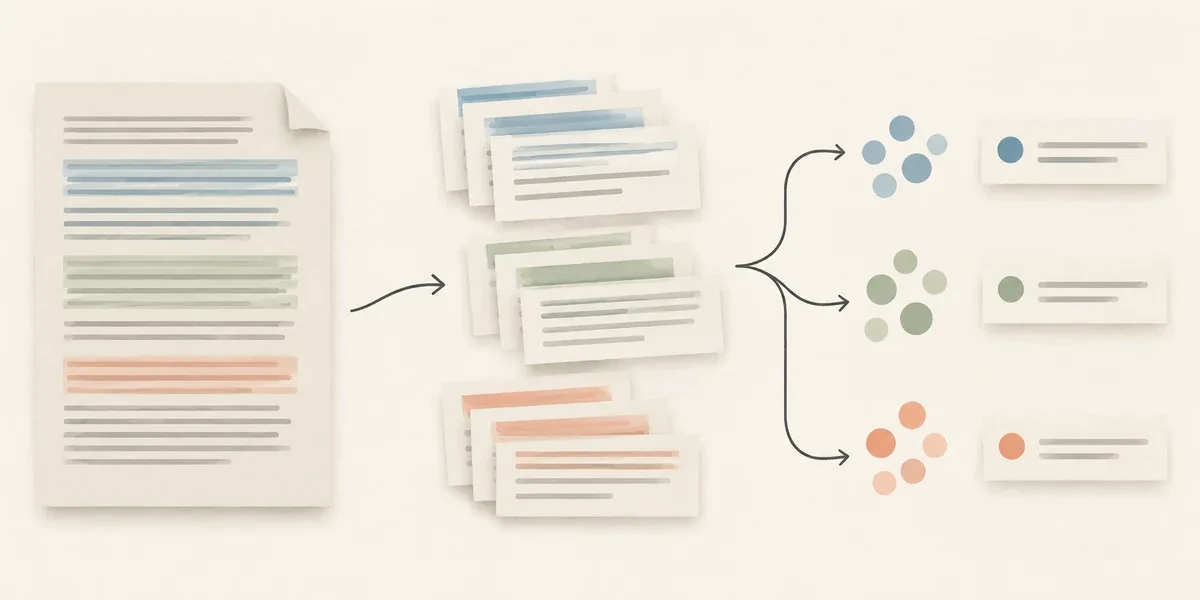
El primer concepto importante es el chunking.
Consiste en dividir documentos grandes en fragmentos más pequeños que puedan recuperarse individualmente.
Imaginemos un manual de doscientas páginas.
Un usuario pregunta:
¿Cómo puedo restablecer mi contraseña?
No necesitamos enviarle al modelo las doscientas páginas.
Necesitamos localizar la sección que explica el procedimiento de recuperación.
Para conseguirlo podemos dividir el documento en fragmentos.
Por ejemplo:
Documento: Manual de usuario

Fragmento 1:
Introducción y descripción de la aplicación.

Fragmento 2:
Proceso de registro de usuarios.

Fragmento 3:
Recuperación de contraseña.

Fragmento 4:
Configuración del perfil.
Cada fragmento puede almacenarse con información adicional:
{
  "documentId": 12,
  "chunkIndex": 3,
  "title": "Recuperación de contraseña",
  "content": "Para recuperar la contraseña...",
  "source": "manual-usuario.pdf"
}
Esta información adicional se denomina metadata.
Nos permite identificar el origen del fragmento, aplicar filtros y construir referencias a los documentos originales.
¿Qué tamaño deben tener los fragmentos?
No existe un tamaño universal.
Los fragmentos pequeños permiten localizar información precisa, pero pueden perder contexto.
Los fragmentos grandes conservan mejor las relaciones entre ideas, aunque pueden introducir información irrelevante.
También podemos utilizar solapamiento entre fragmentos para evitar cortar una explicación justo en un límite.
Por ejemplo:
Chunk 1: párrafos 1, 2 y 3
Chunk 2: párrafos 3, 4 y 5
Chunk 3: párrafos 5, 6 y 7
En sistemas más avanzados podemos dividir por encabezados, secciones o unidades semánticas en lugar de utilizar únicamente un número fijo de caracteres.
La estrategia de chunking afecta directamente a la calidad del RAG.
Embeddings: convertir texto en vectores
El siguiente concepto fundamental son los embeddings.
Un embedding es una representación numérica de un contenido.
En el caso del texto, utilizamos un modelo especializado para transformar una frase o documento en un vector de números.
Por ejemplo, una frase como:
El usuario puede recuperar su contraseña
mediante un enlace enviado por correo.
podría transformarse en algo conceptualmente similar a:
[0.12, -0.43, 0.87, 0.21, -0.08]
Este vector es únicamente ilustrativo. Los modelos reales suelen generar vectores con muchas más dimensiones.
¿Para qué sirve?
La idea es que textos relacionados semánticamente tengan representaciones próximas dentro de un espacio vectorial.
Por ejemplo:
¿Cómo recupero mi contraseña?

He olvidado mi clave de acceso.

No puedo entrar porque no recuerdo mi password.
Aunque las tres frases utilizan palabras diferentes, expresan necesidades similares.
Un modelo de embeddings puede representar esa relación.
Esto permite buscar información no solamente por coincidencias exactas de palabras, sino también por similitud semántica.
¿Qué es una base de datos vectorial?
Una vez generados los embeddings necesitamos almacenarlos y consultarlos.
Podemos utilizar motores especializados como Qdrant, Weaviate o Milvus.
También podemos utilizar bases de datos tradicionales que incorporan capacidades vectoriales.
Un ejemplo especialmente interesante para desarrolladores backend es PostgreSQL con la extensión pgvector.
Supongamos que queremos almacenar fragmentos de documentación.
Podríamos disponer de una tabla como esta:
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE document_chunks (
    id BIGSERIAL PRIMARY KEY,
    document_id BIGINT NOT NULL,
    content TEXT NOT NULL,
    embedding vector(1536),
    created_at TIMESTAMPTZ DEFAULT NOW()
);
El campo embedding almacena el vector del fragmento.
En este ejemplo utilizamos 1536 dimensiones, pero ese valor debe coincidir con el modelo de embeddings elegido.
La consulta ya no consiste necesariamente en buscar palabras mediante LIKE.
Podemos buscar los vectores más próximos al embedding de una pregunta.
Por ejemplo:
SELECT
    id,
    document_id,
    content
FROM document_chunks
ORDER BY embedding <=> $1::vector
LIMIT 5;
En pgvector, el operador <=> calcula la distancia coseno entre dos vectores.
La consulta devuelve los cinco fragmentos más próximos según esa métrica.
Y esos fragmentos serán los candidatos que utilizaremos como contexto para el modelo.
En una aplicación real debemos incorporar filtrado de permisos, control de documentos vigentes e índices apropiados cuando el volumen de información lo justifique.
Segunda fase: responder las preguntas
Ya tenemos nuestros documentos indexados.
Ahora un usuario realiza una pregunta:
¿Cómo puedo recuperar mi contraseña?
El backend ejecuta un proceso parecido al siguiente:
Usuario
   |
   v
Pregunta
   |
   v
Generación del embedding
   |
   v
Búsqueda vectorial
   |
   v
Fragmentos relevantes
   |
   v
Construcción del prompt
   |
   v
LLM
   |
   v
Respuesta
El backend utiliza el mismo modelo de embeddings, o uno compatible con el índice, para convertir la pregunta en un vector.
Después consulta la base de datos vectorial y recupera los fragmentos relevantes.
Finalmente construye el contexto que enviará al LLM.
Por ejemplo:
Eres un asistente de soporte técnico.

Responde utilizando únicamente la información
proporcionada en el contexto.

Si la información no es suficiente,
indícalo claramente.

CONTEXTO:

Documento: Manual de usuario

Para recuperar una contraseña, el usuario debe
seleccionar "He olvidado mi contraseña" e
introducir su correo electrónico.

El sistema enviará un enlace que permitirá
establecer una nueva contraseña.

PREGUNTA:

¿Cómo puedo recuperar mi contraseña?
El LLM recibe la información necesaria para elaborar una respuesta.
Este último paso es importante.
RAG no sustituye al modelo de lenguaje. Le proporciona información relevante antes de generar la respuesta.
Ejemplo de arquitectura RAG con NestJS y PostgreSQL
Veamos ahora cómo podríamos incorporar este sistema a una aplicación web.
Supongamos que utilizamos:
- React para el frontend.
- NestJS para el backend.
- PostgreSQL como base de datos.
- pgvector para almacenar embeddings.
- Una API de modelos de IA para generar embeddings y respuestas.
La arquitectura podría organizarse así:
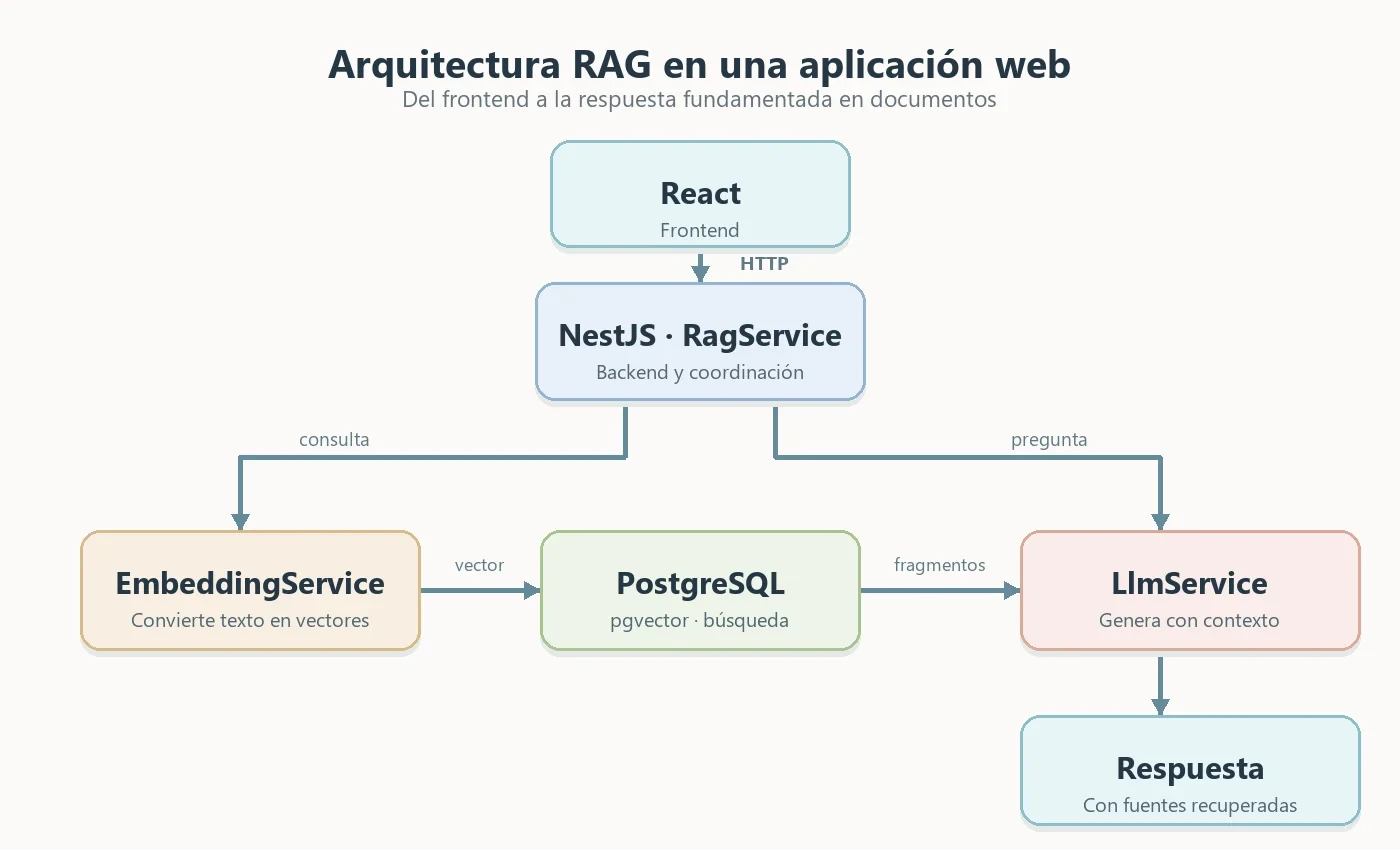
Conviene separar las responsabilidades.
Por ejemplo:
src/
  rag/
    rag.module.ts
    rag.controller.ts
    rag.service.ts

    services/
      embedding.service.ts
      retrieval.service.ts
      generation.service.ts
EmbeddingService transforma texto en vectores.
RetrievalService busca fragmentos relevantes.
GenerationService comunica con el modelo generativo.
RagService coordina el proceso completo.
La estructura exacta dependerá de la complejidad de la aplicación, pero esta separación permite cambiar componentes sin reescribir toda la solución.
Implementación simplificada en TypeScript
Podríamos empezar definiendo una interfaz para los fragmentos recuperados:
interface RetrievedChunk {
  id: number;
  documentId: number;
  content: string;
  score?: number;
}
Después implementamos un servicio que coordine la consulta:
@Injectable()
export class RagService {
  constructor(
    private readonly embeddingService: EmbeddingService,
    private readonly retrievalService: RetrievalService,
    private readonly generationService: GenerationService,
  ) {}

  async ask(question: string, userId: string) {
    const embedding =
      await this.embeddingService.embed(question);

    const chunks =
      await this.retrievalService.search({
        embedding,
        userId,
        limit: 5,
      });

    const context = chunks
      .map((chunk, index) => {
        return `[${index + 1}] ${chunk.content}`;
      })
      .join('\n\n');

    const answer =
      await this.generationService.generate({
        question,
        context,
      });

    return {
      answer,
      sources: chunks.map((chunk) => ({
        documentId: chunk.documentId,
        chunkId: chunk.id,
      })),
    };
  }
}
Este código es conceptual: los servicios auxiliares deben implementarse, y el buscador debe aplicar los permisos de acceso antes de devolver documentos.
La arquitectura, sin embargo, refleja una separación importante.
El proceso de recuperación de información y el proceso de generación son responsabilidades distintas.
Podemos sustituir PostgreSQL por otro motor de búsqueda.
También podemos cambiar el proveedor del LLM sin alterar necesariamente el sistema de almacenamiento.
Un RAG no necesita utilizar siempre búsqueda vectorial
Hasta ahora hemos descrito una implementación basada en embeddings.
Es una arquitectura habitual, pero no la única.
La recuperación de información también puede utilizar:
- búsqueda por palabras clave;
- búsqueda de texto completo;
- filtros estructurados;
- consultas SQL;
- búsqueda híbrida;
- sistemas especializados de recuperación.
Por ejemplo, si un usuario pregunta:
¿Qué significa el error AUTH_4037?
Puede que una búsqueda exacta resulte más eficaz que una búsqueda semántica.
En cambio:
¿Por qué no puedo acceder a mi cuenta?
puede beneficiarse de la búsqueda vectorial.
Por eso muchos sistemas RAG modernos utilizan búsqueda híbrida, combinando búsquedas textuales y vectoriales.
En algunos casos también incorporan una etapa de reranking que vuelve a ordenar los documentos recuperados según su relevancia para la pregunta.
Esto mejora potencialmente la precisión, aunque añade complejidad, coste y latencia.
¿Qué diferencia hay entre RAG y fine-tuning?
Esta es una de las dudas más frecuentes cuando comenzamos a desarrollar aplicaciones con IA.
RAG y fine-tuning permiten adaptar el comportamiento de una solución basada en LLM, pero no resuelven exactamente el mismo problema.
| Característica | RAG | Fine-tuning |
|---|---|---|
| Objetivo principal | Aportar información externa al modelo | Adaptar el comportamiento del modelo |
| Actualizar documentos | Modificar y reindexar la información | No se actualiza automáticamente |
| Conocimiento privado | Recuperado durante la consulta | Depende de los datos y objetivos del entrenamiento |
| Reentrenamiento | No es necesario | Requiere un proceso de entrenamiento |
| Referencias a fuentes | Se pueden incorporar | No aparecen automáticamente |
| Casos habituales | Documentación, soporte, búsqueda | Formatos, estilos y tareas especializadas |
Imaginemos dos necesidades diferentes.
La primera consiste en responder preguntas sobre documentos internos que cambian frecuentemente.
RAG suele ser una alternativa adecuada.
La segunda consiste en conseguir que un modelo produzca respuestas con un formato muy específico o realice una tarea especializada de manera consistente.
En determinados casos, el fine-tuning puede resultar útil.
Ambas técnicas también pueden combinarse.
No son necesariamente excluyentes.
Las alucinaciones siguen siendo un problema
Uno de los argumentos habituales a favor de RAG es que reduce las respuestas inventadas por los modelos.
Esto puede ser cierto cuando el sistema recupera información relevante y el modelo la utiliza correctamente.
Pero conviene evitar una conclusión equivocada.
RAG no elimina las alucinaciones.
Un sistema puede recuperar documentos incorrectos.
Puede encontrar fragmentos desactualizados.
Puede seleccionar contenido poco relevante.
O el LLM puede interpretar incorrectamente la información recibida.
Incluso podría generar una respuesta que no esté respaldada por las fuentes recuperadas.
Por eso resulta importante establecer reglas de generación y mecanismos de verificación.
Por ejemplo:
Utiliza únicamente la información del contexto.

No inventes procedimientos ni requisitos.

Si no encuentras información suficiente,
indica que no puedes responder con seguridad.

Incluye las referencias a los documentos
que respalden la respuesta.
Estas instrucciones ayudan, pero no garantizan el comportamiento del modelo.
En sistemas críticos debemos añadir validaciones y pruebas específicas.
La seguridad es especialmente importante en aplicaciones multiempresa
Imaginemos que estamos construyendo un SaaS utilizado por múltiples empresas.
Cada empresa puede incorporar sus propios documentos.
En ese escenario, una búsqueda vectorial sin restricciones podría recuperar accidentalmente información perteneciente a otra organización.
No basta con indicar al LLM:
No muestres documentos de otras empresas.
La separación debe producirse antes de enviar los fragmentos al modelo.
Por ejemplo, podríamos incorporar un identificador de empresa:
CREATE TABLE document_chunks (
    id BIGSERIAL PRIMARY KEY,
    company_id BIGINT NOT NULL,
    document_id BIGINT NOT NULL,
    content TEXT NOT NULL,
    embedding vector(1536)
);
Y filtrar las consultas:
SELECT
    id,
    document_id,
    content
FROM document_chunks
WHERE company_id = $1
ORDER BY embedding <=> $2::vector
LIMIT 5;
El identificador de empresa debe obtenerse del contexto de autenticación autorizado, no confiarse directamente a un parámetro enviado por el cliente.
Si existen permisos por documento, también deberán aplicarse antes de recuperar el contenido.
Un índice vectorial no sustituye al sistema de autorización de una aplicación.
También debemos recordar que los propios documentos pueden contener instrucciones maliciosas.
Un fragmento recuperado es información, no una orden que el agente deba obedecer.
Por tanto, debemos proteger el sistema frente a ataques de prompt injection, especialmente cuando los documentos proceden de fuentes externas o pueden ser modificados por usuarios.
¿Cómo se mide la calidad de un RAG?
Un error habitual consiste en evaluar el sistema realizando unas cuantas preguntas y comprobando si las respuestas parecen razonables.
Eso puede servir durante las primeras pruebas, pero no es suficiente para una aplicación de producción.
Hay que evaluar al menos dos componentes diferentes.
Calidad de recuperación
¿Hemos encontrado los documentos correctos?
Podemos utilizar métricas como:
- Recall@K: proporción de resultados relevantes recuperados entre los primeros K documentos.
- Precision@K: proporción de resultados relevantes dentro de esos K documentos.
- MRR: mide la posición del primer resultado relevante.
Calidad de generación
¿La respuesta utiliza correctamente la información recuperada?
Aquí podemos evaluar:
- relevancia de la respuesta;
- exactitud respecto a las fuentes;
- ausencia de afirmaciones no respaldadas;
- corrección de las referencias;
- capacidad para reconocer información insuficiente.
También debemos medir características operativas:
Latencia de embeddings
+
Latencia de búsqueda
+
Latencia del LLM
=
Latencia total
Y, naturalmente, el coste.
No tiene sentido implementar un sistema extremadamente sofisticado si tarda veinte segundos en responder preguntas sencillas y cada consulta resulta demasiado cara para nuestro modelo de negocio.
¿Cuándo merece la pena implementar un RAG?
RAG resulta especialmente interesante cuando necesitamos que una aplicación responda preguntas utilizando información externa al modelo.
Por ejemplo:
Asistentes de soporte técnico
Un chatbot puede consultar manuales, preguntas frecuentes o documentación del producto.
Aplicaciones empresariales
Los empleados pueden consultar políticas, procedimientos y documentación interna mediante lenguaje natural.
Plataformas educativas
Los alumnos pueden realizar preguntas sobre materiales de un curso y recibir respuestas basadas en los contenidos.
Sistemas de documentación para desarrolladores
Podemos construir asistentes capaces de responder preguntas sobre una API, una arquitectura o una colección de documentos técnicos.
Aplicaciones SaaS
Cada organización puede disponer de una base de conocimiento privada para sus usuarios autorizados.
Sin embargo, no siempre necesitamos RAG.
Si una aplicación únicamente debe consultar el saldo de una cuenta o recuperar una factura por su identificador, probablemente resulte más adecuado realizar una consulta SQL convencional o utilizar una herramienta de acceso a datos estructurados.
Introducir embeddings y búsqueda vectorial en ese escenario puede añadir complejidad sin aportar valor.
¿Construir nuestro propio RAG o utilizar un servicio gestionado?
Actualmente existen dos aproximaciones principales.
La primera consiste en construir los componentes de recuperación de forma independiente.
Por ejemplo:
NestJS
   +
PostgreSQL
   +
pgvector
   +
API de embeddings
   +
LLM
Esto proporciona control sobre el almacenamiento, los permisos, la indexación y la estrategia de recuperación.
La segunda consiste en utilizar un servicio gestionado que incorpore parte de estas operaciones.
Por ejemplo, OpenAI ofrece herramientas de recuperación y búsqueda sobre archivos mediante almacenes vectoriales.
En estos sistemas parte del trabajo de fragmentación, indexación y recuperación lo realiza el proveedor.
La elección depende de nuestras necesidades.
Si queremos construir rápidamente un prototipo, un servicio gestionado puede resultar conveniente.
Si necesitamos controlar detalladamente los datos, los permisos, la infraestructura o los costes de almacenamiento, una implementación propia puede ser más adecuada.
También debemos tener en cuenta las condiciones de tratamiento de datos cuando trabajamos con información privada o confidencial.
Conclusión: RAG conecta los LLM con los datos de nuestras aplicaciones
RAG es una arquitectura que permite complementar el conocimiento de un modelo de lenguaje con información recuperada de fuentes externas.
Su funcionamiento combina conceptos que los desarrolladores ya conocemos:
- procesamiento de documentos;
- indexación;
- bases de datos;
- búsqueda de información;
- APIs;
- servicios backend;
- control de acceso.
La principal novedad está en cómo conectamos esas piezas con los modelos de lenguaje.
Los embeddings permiten recuperar documentos por similitud semántica.
Las bases de datos vectoriales facilitan ese tipo de consultas.
Y los LLM utilizan los fragmentos encontrados para construir respuestas en lenguaje natural.
Pero el verdadero desafío no consiste únicamente en conectar una base de datos con una API de inteligencia artificial.
Consiste en recuperar la información correcta, respetar los permisos, controlar los costes, evaluar los resultados y evitar que el modelo presente información inventada como si fuera cierta.
Un RAG bien diseñado no convierte a un LLM en una fuente infalible. Lo convierte en una interfaz más útil para consultar información que nuestra aplicación ya posee.
Y precisamente por eso RAG se ha convertido en una pieza importante de la arquitectura de muchas aplicaciones que incorporan inteligencia artificial.